Indice / Visualizacion con Matplotlib / 8.2
Elegir el gráfico según la pregunta
No se elige por gusto ni por variedad. Se elige por la pregunta que tiene que contestar y por el tipo de variable que hay del otro lado.
Para qué sirve
La pregunta «¿qué gráfico uso?» tiene una respuesta corta y aburrida casi siempre. Hay cuatro tareas analíticas que cubren la enorme mayoría del trabajo, y cada una tiene su tipo de gráfico. Elegir mal no da error: da una figura prolija que responde otra cosa.
| Pregunta | Tarea | Gráfico | Ejemplo del curso |
|---|---|---|---|
| ¿Cómo cambia con el tiempo? | Tendencia | Línea | Ventas por día |
| ¿Qué categoría tiene más? | Comparación | Barras, base en cero | Importe por sucursal |
| ¿Dónde se concentran los valores? | Distribución | Histograma | Notas del curso |
| ¿Estas dos varían juntas? | Relación | Dispersión | Cantidad contra ingreso |
La misma columna puede necesitar dos gráficos distintos si le hacés dos preguntas distintas. Eso no es indecisión: es que son dos análisis.
La idea: la línea promete que existe lo que hay en el medio
Una línea no es «puntos unidos para que se vea mejor». La unión afirma que entre dos puntos hay valores intermedios y que el orden del eje horizontal es real. Con meses eso es cierto: entre marzo y abril pasó el tiempo. Con medios de transporte no: no hay nada entre Subte y Bicicleta, y si reordenás las filas la línea cambia de forma sin que haya cambiado un solo dato.
import pandas as pd
import matplotlib.pyplot as plt

medios = pd.DataFrame({"medio": ["Colectivo", "Subte", "Bicicleta", "Auto", "A pie"],
                       "cantidad": [120, 95, 48, 62, 75]})

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4))

axes[0].plot(medios["medio"], medios["cantidad"], marker="o")
axes[0].set_title("Con linea: mal")
axes[0].set_ylabel("Estudiantes")

axes[1].bar(medios["medio"], medios["cantidad"])
axes[1].set_title("Con barras: bien")
axes[1].set_ylabel("Estudiantes")

for eje in axes:
    eje.tick_params(axis="x", labelrotation=45)
fig.tight_layout()
plt.show()

print(medios.to_string(index=False))
print()
print("La linea de la izquierda dibuja un punto entre Subte y Bicicleta.")
print("Ese punto no existe: no hay nada 'entre' dos categorias.")
print("Y si se reordenan las filas, la linea cambia de forma sin que")
print("haya cambiado un solo dato.")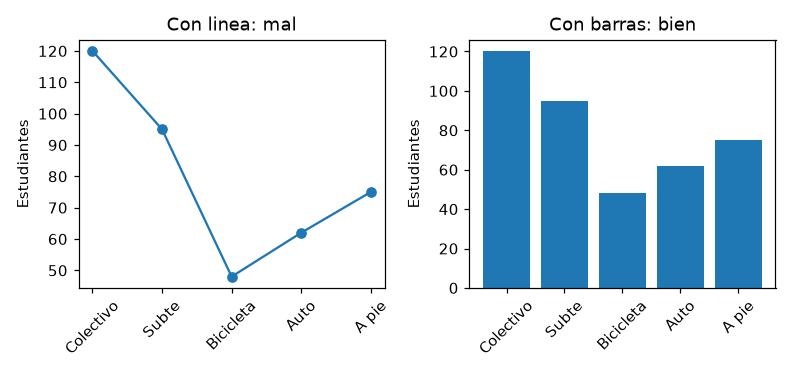
    medio  cantidad
Colectivo       120
    Subte        95
Bicicleta        48
     Auto        62
    A pie        75

La linea de la izquierda dibuja un punto entre Subte y Bicicleta.
Ese punto no existe: no hay nada 'entre' dos categorias.
Y si se reordenan las filas, la linea cambia de forma sin que
haya cambiado un solo dato.ELI5Explicado facil
Es la diferencia entre una escalera y una fila de personas.
- Los escalones tienen un orden que existe de verdad: el tercero está entre el segundo y el cuarto, siempre. Podés dibujar una rampa que los una.
- Las personas de una fila están en un orden que decidió alguien. Si las reordenás, la fila sigue teniendo sentido. Dibujar una rampa sobre ellas es inventar que hay «media persona» entre dos.
Línea para escalones. Barras para personas.
Sobre datos de verdad
Una columna, dos preguntas
import pandas as pd
import matplotlib.pyplot as plt

tx = pd.read_csv("transacciones_sucursales.csv")

# between(0, 100000) deja afuera cuatro filas: dos importes ausentes, uno
# negativo y uno de ocho digitos. Las cuatro son imposibles, no raras. Se
# informan; por que el de ocho digitos deforma el grafico, en la leccion 8.4.
importe = pd.to_numeric(tx["importe"], errors="coerce")
posibles = tx.loc[importe.between(0, 100000)].copy()
posibles["importe"] = importe[importe.between(0, 100000)]
print("descartadas:", len(tx) - len(posibles), "de", len(tx))

por_sucursal = posibles.groupby("sucursal")["importe"].sum().sort_values()

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4))

axes[0].barh(por_sucursal.index, por_sucursal.to_numpy())
axes[0].set_title("Cuanto suma cada sucursal")
axes[0].set_xlabel("Importe total")

axes[1].hist(posibles["importe"], bins=12, edgecolor="white")
axes[1].set_title("Como se reparten los importes")
axes[1].set_xlabel("Importe")
axes[1].set_ylabel("Transacciones")

fig.tight_layout()
plt.show()

print()
print(por_sucursal.round(2).to_string())
print()
print(posibles["importe"].describe().round(2).to_string())
print()
print("Misma columna, dos preguntas. 'Cuanto por sucursal' es comparacion y")
print("va en barras. 'Como se reparten' es distribucion y va en histograma.")
print("Ninguno de los dos responde la pregunta del otro.")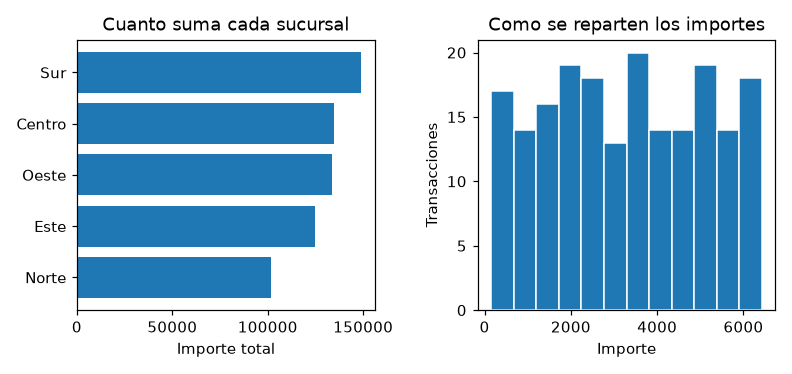
descartadas: 4 de 200

sucursal
Norte     101889.41
Este      124833.64
Oeste     133789.43
Centro    134475.27
Sur       148662.45

count     196.00
mean     3283.93
std      1822.78
min       150.35
25%      1763.80
50%      3332.05
75%      4924.32
max      6428.97

Misma columna, dos preguntas. 'Cuanto por sucursal' es comparacion y
va en barras. 'Como se reparten' es distribucion y va en histograma.
Ninguno de los dos responde la pregunta del otro.
Las barras dicen que Sur suma más y Norte menos, y no dicen nada sobre si eso viene de muchas transacciones chicas o de pocas grandes. El histograma dice que casi todos los importes están entre 1.700 y 4.900, y no dice nada sobre a qué sucursal pertenecen. Ninguno de los dos responde la pregunta del otro, y los dos son correctos.
Lo que el ojo mide bien y lo que mide mal
Las personas leen algunas codificaciones con mucha más precisión que otras. El orden está estudiado y es bastante estable:
| Codificación | Precisión | Dónde aparece |
|---|---|---|
| Posición sobre una escala común | Muy alta | Líneas, dispersión, barras |
| Longitud | Alta | Barras |
| Ángulo o área | Media | Tortas, burbujas |
| Color por intensidad | Media | Mapas de calor |
| Forma o color categórico | Útil con pocas clases | Grupos en una dispersión |
import pandas as pd
import matplotlib.pyplot as plt

reparto = pd.DataFrame({"canal": ["Web", "Tienda", "App", "Telefono", "Mail"],
                        "ventas": [312, 298, 205, 118, 67]})

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4))

axes[0].barh(reparto["canal"], reparto["ventas"])
axes[0].invert_yaxis()
axes[0].set_title("Longitud sobre una base comun")
axes[0].set_xlabel("Ventas")

axes[1].pie(reparto["ventas"], labels=reparto["canal"])
axes[1].set_title("Angulo y area")

fig.tight_layout()
plt.show()

print(reparto.to_string(index=False))
print()
total = reparto["ventas"].sum()
for canal, ventas in zip(reparto["canal"], reparto["ventas"]):
    print(f"  {canal:<9} {ventas:>4}  {ventas / total * 100:5.1f} %")
print()
print("Web y Tienda difieren en 14 ventas, un 1,4 % del total.")
print("En las barras se ve cual es mayor. En la torta hay que leer la")
print("etiqueta, y entonces el grafico no esta aportando nada.")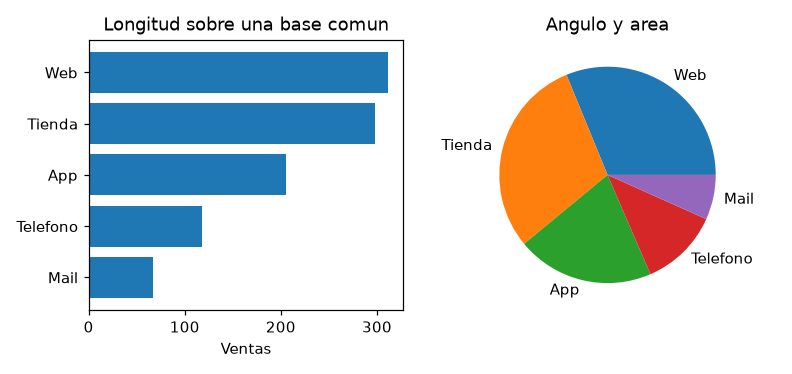
   canal  ventas
     Web     312
  Tienda     298
     App     205
Telefono     118
    Mail      67

  Web        312   31.2 %
  Tienda     298   29.8 %
  App        205   20.5 %
  Telefono   118   11.8 %
  Mail        67    6.7 %

Web y Tienda difieren en 14 ventas, un 1,4 % del total.
En las barras se ve cual es mayor. En la torta hay que leer la
etiqueta, y entonces el grafico no esta aportando nada.Si la comparación precisa importa, usá posición y longitud. El color sirve para destacar el hallazgo, no para reemplazar la estructura: si sacar el color deja el gráfico ilegible, el color estaba haciendo el trabajo que tendría que hacer la posición.
Acá hay que elegir
Dos líneas en un eje se comparan muy bien. Cinco se cruzan y hay que seguir cada una por el color, que es justo la codificación que peor se lee. No hay un número mágico, pero hay una prueba: si para leer el gráfico tenés que ir y volver a la leyenda, hay demasiadas series.
Las salidas habituales son tres, y las tres son legítimas: destacar una serie y
dejar el resto en gris, separar en varios ejes con la misma escala
(sharey=True), o agrupar las categorías chicas en «otros» y decirlo en el
título.
Dónde se rompe
Causa: se usó línea sobre un eje sin orden natural. La forma del gráfico depende del orden de las filas, que no es un dato.
Arreglo: barras. Y si querés ordenarlas, ordenalas por el valor, que sí es un criterio defendible.
Causa: hay un valor extremo que estira el rango, así que todos los demás caen en el primer intervalo.
Arreglo: es la lección 8.5. El histograma está bien elegido; el problema es de datos.
Causa: el ángulo se lee peor que la longitud, y con doce clases ya no se lee nada.
Arreglo: barras horizontales ordenadas. Una torta se defiende con dos o tres partes de un total, y aun así las barras suelen ganar.
Causa: se eligió el gráfico de una pregunta y se está intentando contestar la otra.
Arreglo: dos gráficos, uno por pregunta, o uno con las series separadas. Un gráfico bien elegido contesta una sola pregunta bien.
Recetario
| Si la pregunta es | El gráfico es | La llamada |
|---|---|---|
| Cómo evoluciona en el tiempo | Línea | ax.plot(fecha, valor) |
| Cuánto por categoría | Barras verticales | ax.bar(cat, valor) |
| Cuánto por categoría, con nombres largos | Barras horizontales | ax.barh(cat, valor) |
| Cómo se reparte una variable | Histograma | ax.hist(valor, bins=12) |
| Si dos variables van juntas | Dispersión | ax.scatter(x, y) |
| Cómo se reparte, comparando grupos | Cajas | ax.boxplot([a, b, c]) |
| Dos gráficos comparables | Misma escala | plt.subplots(1, 2, sharey=True) |
| Ordenar las barras por valor | Antes de dibujar | serie.sort_values() |
| Destacar una categoría | Color de acento | ax.bar(..., color=colores) |