Indice / Visualizacion con Seaborn / 9.2
Mapa de calor: correlación y tabla pivote
Una matriz coloreada contesta de un vistazo qué se mueve junto con qué. También es el gráfico más fácil de leer mal, y el que un solo dato sucio arruina sin avisar.
Para qué sirve
Con dos variables alcanza una dispersión. Con seis, las dispersiones son quince y nadie las mira. El mapa de calor resume todos esos pares en una grilla: cada celda es un número, y el color permite recorrerla sin leer celda por celda.
Se usa para dos cosas distintas que conviene no mezclar: una matriz de correlación, donde filas y columnas son las mismas variables, y una tabla pivote, donde filas y columnas son dos categorías y la celda es un agregado. Las dos se dibujan igual y se colorean distinto.
El ejemplo mínimo
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

campania = pd.DataFrame({
    "visitas": [1200, 1500, 1800, 2100, 2400, 2700, 3000, 3300],
    "publicidad": [100, 130, 160, 190, 220, 250, 280, 310],
    "ventas": [45, 52, 61, 68, 79, 84, 95, 101],
    "devoluciones": [9, 8, 8, 6, 6, 5, 4, 3]})

corr = campania.corr()
print("matriz de correlacion:")
print(corr.round(3).to_string())

fig, ax = plt.subplots()
sns.heatmap(corr, annot=True, fmt=".2f", cmap="vlag",
            vmin=-1, vmax=1, linewidths=0.5, ax=ax)
ax.set_title("Correlacion entre variables de la campania")
fig.tight_layout()
plt.show()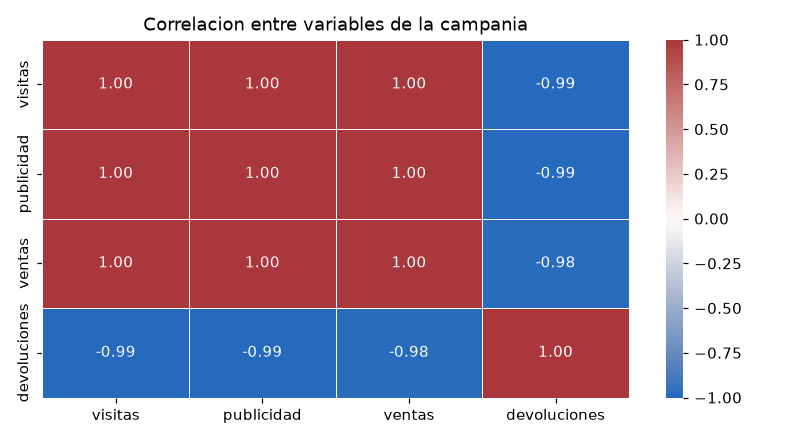
matriz de correlacion:
              visitas  publicidad  ventas  devoluciones
visitas         1.000       1.000   0.998        -0.986
publicidad      1.000       1.000   0.998        -0.986
ventas          0.998       0.998   1.000        -0.980
devoluciones   -0.986      -0.986  -0.980         1.000
df.corr() devuelve un DataFrame cuadrado, y sns.heatmap lo
dibuja tal cual: annot=True escribe el número en cada celda y
fmt=".2f" lo recorta a dos decimales. La diagonal vale 1 siempre, porque
cada variable está perfectamente correlacionada consigo misma.
La idea: una divergente necesita su centro fijado a mano
La intuición que hay que corregir acá es «rojo significa importante». En una paleta
divergente como vlag, rojo y azul son los dos extremos de un
signo, y el blanco del medio es el cero. Eso solo se cumple si el cero está en
el centro de la escala, y por defecto no lo está: Seaborn ajusta el rango a los datos.
vmin=-1, vmax=1 no es decoración
Sin esos dos argumentos, una matriz cuyo mínimo sea 0,3 pinta ese
0,3 del color más frío de la paleta, que el ojo lee como «negativo». Y dos
mapas de calor hechos sobre datos distintos dejan de ser comparables entre sí, porque
cada uno tiene su propia escala.
Para correlación el rango correcto es siempre el mismo y se conoce de antemano: de −1 a 1. Fijarlo cuesta dos argumentos y evita la lectura equivocada.
Sobre datos de verdad
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

hechos = pd.read_csv("dw_hecho_ventas.csv")
medidas = hechos[["cantidad", "ingreso", "costo"]]

corr = medidas.corr()
print("matriz de correlacion sobre las 500 filas, tal cual vienen:")
print(corr.round(3).to_string())

# El par mas asociado, sin contar la diagonal.
pares = corr.stack()
pares = pares[pares.index.get_level_values(0) < pares.index.get_level_values(1)]
a, b = pares.abs().idxmax()
print("\npar mas asociado:", a, "y", b, "->", round(float(pares[(a, b)]), 3))
print("filas usadas por columna:")
print(medidas.notna().sum().to_string())

fig, ax = plt.subplots()
sns.heatmap(corr, annot=True, fmt=".2f", cmap="vlag",
            vmin=-1, vmax=1, linewidths=0.5, ax=ax)
ax.set_title("Correlacion de las medidas de venta")
fig.tight_layout()
plt.show()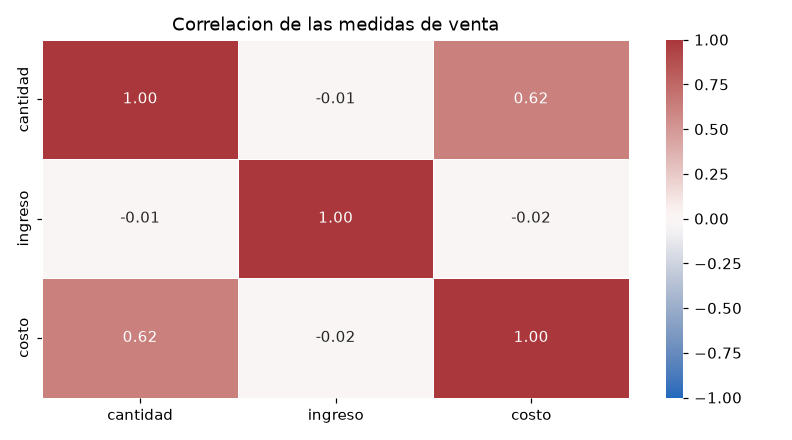
matriz de correlacion sobre las 500 filas, tal cual vienen:
          cantidad  ingreso  costo
cantidad     1.000   -0.010  0.618
ingreso     -0.010    1.000 -0.019
costo        0.618   -0.019  1.000

par mas asociado: cantidad y costo -> 0.618
filas usadas por columna:
cantidad    499
ingreso     500
costo       498
El resultado es raro y vale la pena detenerse. cantidad y
costo van juntas, con 0,618, que tiene todo el sentido: vender
más unidades cuesta más. Pero ingreso no se asocia con nada:
−0,010 con cantidad y −0,019 con costo. Un negocio donde lo que se
factura no tiene relación con lo que se vende ni con lo que cuesta.
Eso no es un hallazgo. Es un síntoma.
La fila que sostiene toda la matriz
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

hechos = pd.read_csv("dw_hecho_ventas.csv")
medidas = ["cantidad", "ingreso", "costo"]

# La fila 480 declara diez unidades y un ingreso de siete digitos: el dominio
# del ingreso llega a 100000, asi que es imposible, no atipico.
imposible = hechos["ingreso"] > 100000
print("filas fuera del dominio del ingreso:", int(imposible.sum()))
print(hechos.loc[imposible, ["venta_id", "cantidad", "ingreso", "costo"]]
      .to_string(index=False))

con = hechos[medidas].corr()
sin = hechos.loc[~imposible, medidas].corr()

print("\ncon la fila adentro:")
print(con.round(3).to_string())
print("\ncon la fila afuera:")
print(sin.round(3).to_string())
print("\ningreso contra costo:", round(float(con.loc["ingreso", "costo"]), 3),
      "->", round(float(sin.loc["ingreso", "costo"]), 3))

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4))
for ax, datos, titulo in ((axes[0], con, "Con la fila 480"),
                          (axes[1], sin, "Sin la fila 480")):
    sns.heatmap(datos, annot=True, fmt=".2f", cmap="vlag",
                vmin=-1, vmax=1, linewidths=0.5, cbar=False, ax=ax)
    ax.set_title(titulo)
fig.tight_layout()
plt.show()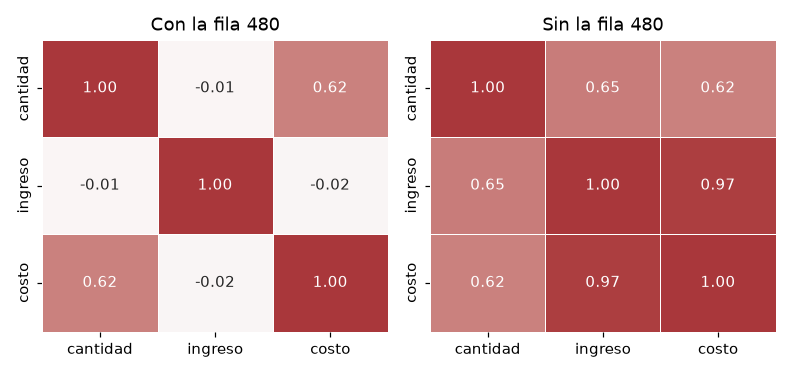
filas fuera del dominio del ingreso: 1
 venta_id  cantidad    ingreso  costo
      480      10.0 9999999.99 1272.4

con la fila adentro:
          cantidad  ingreso  costo
cantidad     1.000   -0.010  0.618
ingreso     -0.010    1.000 -0.019
costo        0.618   -0.019  1.000

con la fila afuera:
          cantidad  ingreso  costo
cantidad     1.000    0.645  0.618
ingreso      0.645    1.000  0.968
costo        0.618    0.968  1.000

ingreso contra costo: -0.019 -> 0.968
Una fila de quinientas. La venta 480 declara diez unidades, un costo de 1.272 pesos y un ingreso de 9.999.999,99, cuando el dominio declarado del ingreso llega a 100.000. No es un caso atípico: es imposible.
Sacándola, ingreso contra costo pasa de
−0,019 a 0,968. La asociación más fuerte de toda la tabla estaba
escondida detrás de un solo valor mal cargado, y el mapa de calor no dio ninguna señal:
salió sin error, con colores, con números y perfectamente legible.
La correlación de Pearson se calcula sobre desvíos respecto de la media. Un valor cuatro órdenes de magnitud más grande que el resto corre la media de la columna y domina la suma de productos. Las 499 filas normales quedan, en términos numéricos, apretadas contra el cero.
Es el mismo mecanismo que en la lección 8.6 daba vuelta el signo de la recta. Cambia el gráfico, no cambia la causa.
Lo mismo, paso a paso
Leer una matriz de correlación es leer tres cosas en cada celda, en este orden:
- El signo. Positivo: suben juntas. Negativo: cuando una sube, la otra baja.
- La magnitud. Cerca de 1 o de −1, los puntos están pegados a una recta. Cerca de 0, no hay relación lineal, que no es lo mismo que no haber relación: una U perfecta da cerca de cero.
- Cuántas filas la sostienen. Es lo que nunca está en el gráfico.
Por eso el ejemplo imprime
notna().sum()por columna.
Cuando el mapa no es de correlación
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

accesos = pd.read_csv("servidor_acceso.csv")
momento = pd.to_datetime(accesos["fecha_hora"], format="ISO8601", errors="coerce")
print("filas:", len(accesos), "| fecha_hora ilegible:", int(momento.isna().sum()))

datos = accesos[momento.notna()].assign(hora=momento[momento.notna()].dt.hour.astype(int))
demanda = datos.pivot_table(index="metodo", columns="hora",
                            values="ip", aggfunc="count", fill_value=0)
print("\naccesos por metodo y hora:")
print(demanda.to_string())

pico = demanda.stack().idxmax()
print("\npico de demanda:", pico[0], "a las", pico[1], "->",
      int(demanda.loc[pico[0], pico[1]]), "accesos")
print("total por metodo:")
print(demanda.sum(axis=1).sort_values(ascending=False).to_string())

fig, ax = plt.subplots()
sns.heatmap(demanda, annot=True, fmt="d", cmap="YlOrRd",
            linewidths=0.5, cbar_kws={"label": "accesos"}, ax=ax)
ax.set_title("Accesos por metodo y hora del dia")
ax.set_xlabel("Hora")
ax.set_ylabel("Metodo")
fig.tight_layout()
plt.show()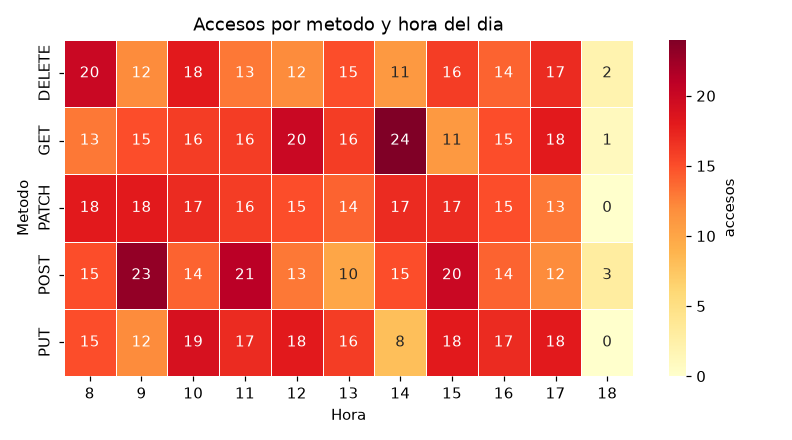
filas: 794 | fecha_hora ilegible: 1

accesos por metodo y hora:
hora    8   9   10  11  12  13  14  15  16  17  18
metodo
DELETE  20  12  18  13  12  15  11  16  14  17   2
GET     13  15  16  16  20  16  24  11  15  18   1
PATCH   18  18  17  16  15  14  17  17  15  13   0
POST    15  23  14  21  13  10  15  20  14  12   3
PUT     15  12  19  17  18  16   8  18  17  18   0

pico de demanda: GET a las 14 -> 24 accesos
total por metodo:
metodo
GET       165
POST      160
PATCH     160
PUT       158
DELETE    150
Acá las filas son métodos HTTP, las columnas son horas y la celda es un conteo. Nada
de eso tiene signo, así que la paleta correcta es secuencial
(YlOrRd va de claro a intenso) y no divergente, y no hay ningún
vmin ni vmax natural que fijar: el rango son los datos.
Es la misma función y la decisión de color es la opuesta. De ahí que convenga preguntarse siempre qué significa el cero antes de elegir la paleta.
Acá hay que elegir
- Divergente (
vlag,coolwarm,RdBu) cuando el cero es un punto de referencia real y el signo importa: correlaciones, diferencias contra un objetivo, variaciones porcentuales. Siempre con el rango fijado a mano y simétrico. - Secuencial (
YlOrRd,viridis,Blues) cuando la variable solo crece: conteos, importes, tiempos, cantidades. Acá el cero es simplemente el mínimo y no merece un color propio. - Nunca una divergente sobre conteos: pinta de un color frío la mitad baja del rango y sugiere un signo negativo que no existe.
Y una advertencia sobre viridis y compañía: son legibles en escala de
grises y para daltonismo, que es una razón real para preferirlas a
jet o rainbow.
Dónde se rompe
Causa: le pasaste a heatmap un DataFrame con columnas de
texto. El heatmap dibuja números, no tablas cualesquiera.
Arreglo: df.select_dtypes("number").corr(), o armá la tabla
pivote con pivot_table y un aggfunc numérico.
Causa: hay una celda con un valor enorme que se lleva todo el rango de la escala, y el resto queda comprimido en un extremo.
Arreglo: en correlación, fijá vmin=-1, vmax=1. En una tabla
pivote, buscá el valor máximo con .stack().idxmax() y revisá si es real
antes de graficar.
Causa: un valor fuera de dominio, o una relación que no es lineal.
Arreglo: primero filtrá por el dominio declarado de cada columna y volvé a calcular. Si sigue baja, mirá la dispersión: puede ser una curva.
Causa: corr() ignora las no numéricas en silencio. Una columna
que quedó como object por un token de texto no aparece.
Arreglo: comprobá df.dtypes antes. Lo que debería ser número y
es object, se convierte con pd.to_numeric.
Causa: demasiadas variables para el ancho de la figura.
Arreglo: con más de diez o doce variables, sacá annot y dejá
solo el color, o seleccioná antes las columnas que te interesan. Una matriz de 30 por
30 anotada no la lee nadie.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
df.corr() | Matriz de Pearson, ignora las no numéricas | Explorar asociaciones lineales |
df.select_dtypes("number") | Se queda con las columnas numéricas | Antes de corr, para saber qué entró |
sns.heatmap(m, annot=True, fmt=".2f") | Dibuja y escribe el valor | Hasta diez o doce variables |
vmin=-1, vmax=1 | Fija la escala completa | Siempre, en correlación |
cmap="vlag" | Paleta divergente, blanco en el centro | Cuando el signo importa |
cmap="YlOrRd" | Paleta secuencial | Conteos, importes, tiempos |
linewidths=0.5 | Separa las celdas | Grillas chicas, mejora la lectura |
cbar_kws={"label": "accesos"} | Rotula la barra de color | Siempre que la unidad no sea obvia |
df.pivot_table(index=, columns=, values=, aggfunc=) | Tabla de dos categorías | Heatmap que no es de correlación |
fill_value=0 | Rellena las celdas sin datos | Cuando el vacío significa cero |
m.stack().idxmax() | Fila y columna del máximo | Localizar el pico |
fmt="d" | Anota enteros sin decimales | Conteos |